
Primeiros experimentos de inferência local na RTX 5060 Ti
Depois de colocar a RTX 5060 Ti de 16 GB dentro da ai-01 via PCI passthrough no Proxmox, fiz alguns testes simples com llama.cpp antes de pensar em uma stack mais robusta. A cadeia ficou Proxmox → VFIO → Ubuntu Server 26.04 → NVIDIA 595-open → CUDA 13.x → llama.cpp → GGUF.
Usei o mesmo prompt em todos os testes e mantive -ngl 99 para offloadar praticamente tudo para a GPU:
| Modelo | Quantização | Prompt (t/s) | Geração (t/s) |
|---|---|---|---|
| Qwen3-4B | Q4_K_M | 797.7 | 125.6 |
| Qwen3-8B | Q4_K_M | 677.9 | 78.9 |
| Qwen3-14B | Q4_K_M | 493.4 | 44.9 |
| Qwen3-14B | Q5_K_M | 459.6 | 39.4 |
O Qwen3-14B em Q5_K_M ocupou cerca de 14.8 GB dos 16.3 GB disponíveis, então ele parece estar muito próximo do limite confortável da placa. Mesmo assim, quase 40 tokens por segundo ainda é mais do que suficiente para uso interativo. Até aqui, esse 14B Q5 parece ser o ponto mais interessante entre tamanho do modelo, qualidade da quantização e velocidade.
Por cima desses modelos, também estou testando harnesses de agentes de código. O principal é o DSH (DeepSeek Harness); OpenCode e Pi (agente de código) vêm na sequência.
O próximo experimento é ultrapassar deliberadamente os 16 GB de VRAM com modelos maiores, na faixa de 20B a 32B, para observar o custo de dividir o modelo entre GPU e RAM. A pergunta que começou como “qual modelo é mais rápido?” já está mudando para algo mais útil: qual é o melhor modelo que ainda responde mais rápido do que eu consigo ler?
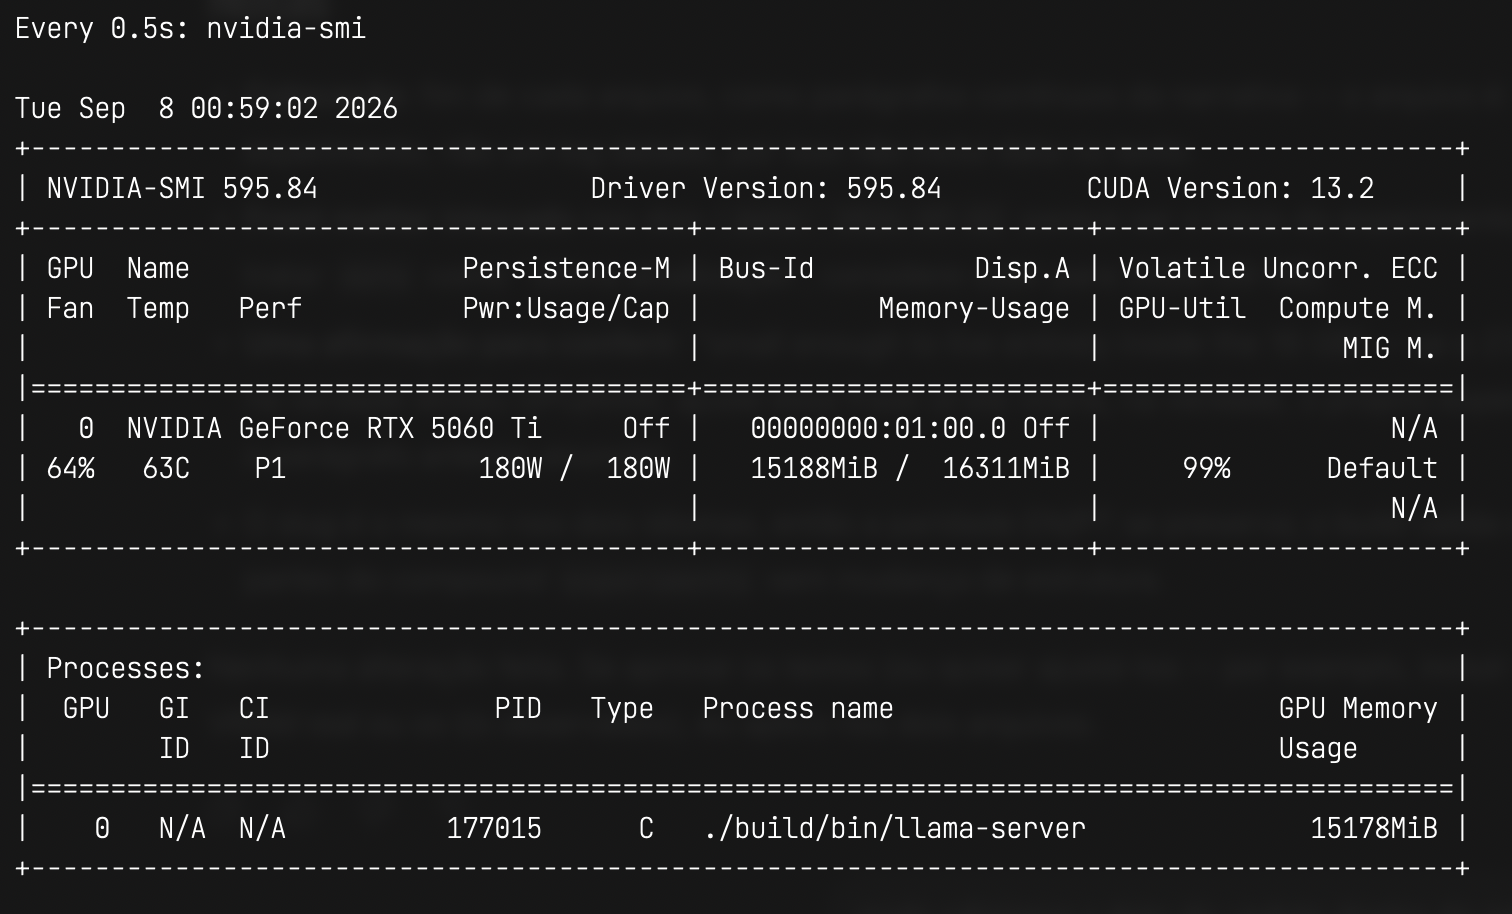
2026-09-06 — antes do experimento de VRAM, o primeiro teste real do harness aconteceu. Rodei o llama-server na ai-01 com o GGUF Qwen3.8-27B-IQ3_XXS do bartowski — um modelo de 27B que vive 100% na VRAM, em 15188 MiB dos 16311 MiB disponíveis — e apontei o DSH, rodando no MacBook, para a VM. Pela primeira vez o harness e o modelo estiveram em máquinas diferentes: o laptop fica sendo a interface, a workstation faz o trabalho.
Um ponto de atrito: o DSH espera uma chave de API, e o llama-server não emite nenhuma. A solução foi trivial — o campo aceita qualquer valor, então ele agora diz local, um placeholder honesto sobre o que é.
Os resultados estão satisfatórios para uso interativo. Antes do experimento de 20B a 32B, duas coisas para registrar: se a quantização IQ3_XXS se sustenta em sessões longas de agente, e quanto de latência o salto do MacBook para a VM realmente custa.