wip · Seguindo sinais físicos de um sensor até informação localmente visível.
O nó sensor ESP32 coleta leituras de temperatura, umidade e luz ambiente da bancada de trabalho.
A parte útil do experimento é entender o caminho inteiro: tensão no sensor, conversão no microcontrolador, transporte pela rede local e apresentação sem um serviço de nuvem.
Perguntas atuais:
quanto de filtragem pertence ao dispositivo;
como preservar leituras úteis durante interrupções de rede;
quão pouca interface é necessária para entender o que o ambiente está fazendo.
Comandos, escolhas de configuração e explicações que quero poder encontrar de novo. Estas notas valorizam o motivo por trás de uma mudança, não apenas a invocação final.
O nó sensor ESP32 coleta leituras de temperatura, umidade e luz ambiente da bancada de trabalho.
A parte útil do experimento é entender o caminho inteiro: tensão no sensor, conversão no microcontrolador, transporte pela rede local e apresentação sem um serviço de nuvem.
Perguntas atuais:
quanto de filtragem pertence ao dispositivo;
como preservar leituras úteis durante interrupções de rede;
quão pouca interface é necessária para entender o que o ambiente está fazendo.
Este experimento pergunta quão pouca maquinaria um caderno pessoal durável precisa.
As restrições de trabalho são arquivos simples, operação offline, sincronização compreensível e um formato de exportação que não exige o aplicativo original.
A interface é deliberadamente secundária. A primeira preocupação é se as anotações continuam legíveis e portáveis depois que o software desaparece.
Um pequeno dispositivo escuta um console serial, marca o horário de cada linha e grava arquivos de log rotativos no armazenamento local.
O registrador deve tolerar quedas de energia repentinas, não fazer suposições sobre o dispositivo de destino e expor seus arquivos através de um volume removível comum.
O próximo passo é testar como ele se comporta com saída malformada e longos períodos de silêncio.
Uma TV box antiga, parada sem uso, está sendo transformada em um nó do
homelab: algo pequeno que possa rodar um resolvedor DNS Unbound ou, mais
adiante, um broker MQTT.
Hardware: Rockchip RK3228, kernel 3.10.104 (2020), 4 GB de RAM, 64 GB de eMMC.
Primeira tentativa, 23 de agosto:
gravei o Armbian em um cartão SD e tentei dar boot a partir dele;
a placa não deu boot pelo cartão SD;
próximo passo: entender por que o RK3228 ignora o cartão.
A tentativa de boot em vídeo:
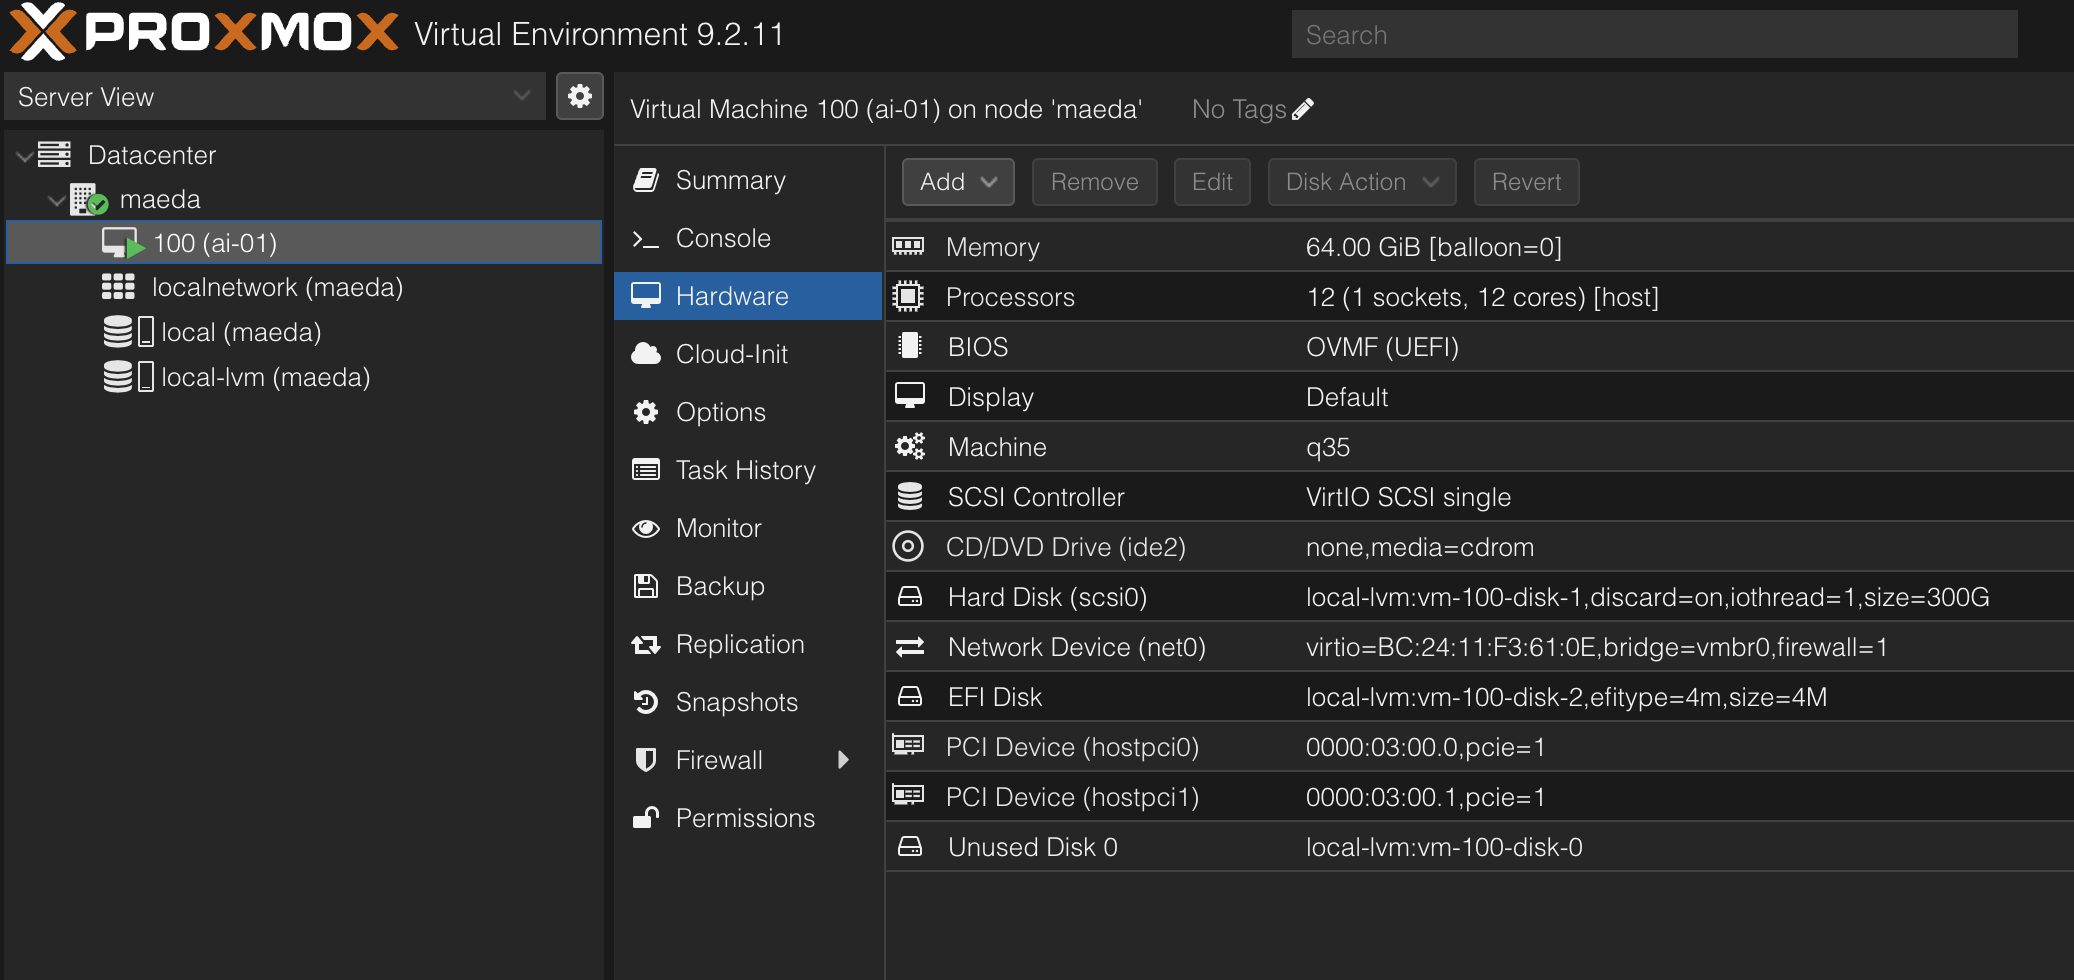
A workstation roda Proxmox VE. A primeira VM Linux está no ar — ai-01, um
Ubuntu Server com a RTX 5060 Ti passada por passthrough — e os primeiros
modelos locais já estão rodando nela.
O passthrough da GPU funcionou de ponta a ponta. Próximo: mais guests, o
layout de storage e o resto da rede.
A rede do homelab está sendo montada num rack: um switch gerenciado, o roteador
de borda e as máquinas, todos conversando entre si. É o encanamento sobre o
qual todos os outros experimentos vão rodar.
Ainda em andamento: passar cabos, VLANs e qual máquina usa qual porta.
Depois de colocar a RTX 5060 Ti de 16 GB dentro da ai-01 via PCI passthrough no Proxmox, fiz alguns testes simples com llama.cpp antes de pensar em uma stack mais robusta. A cadeia ficou Proxmox → VFIO → Ubuntu Server 26.04 → NVIDIA 595-open → CUDA 13.x → llama.cpp → GGUF.
Usei o mesmo prompt em todos os testes e mantive -ngl 99 para offloadar praticamente tudo para a GPU:
Modelo
Quantização
Prompt (t/s)
Geração (t/s)
Qwen3-4B
Q4_K_M
797.7
125.6
Qwen3-8B
Q4_K_M
677.9
78.9
Qwen3-14B
Q4_K_M
493.4
44.9
Qwen3-14B
Q5_K_M
459.6
39.4
O Qwen3-14B em Q5_K_M ocupou cerca de 14.8 GB dos 16.3 GB disponíveis, então ele parece estar muito próximo do limite confortável da placa. Mesmo assim, quase 40 tokens por segundo ainda é mais do que suficiente para uso interativo. Até aqui, esse 14B Q5 parece ser o ponto mais interessante entre tamanho do modelo, qualidade da quantização e velocidade.
Por cima desses modelos, também estou testando harnesses de agentes de código. O principal é o DSH (DeepSeek Harness); OpenCode e Pi (agente de código) vêm na sequência.
O próximo experimento é ultrapassar deliberadamente os 16 GB de VRAM com modelos maiores, na faixa de 20B a 32B, para observar o custo de dividir o modelo entre GPU e RAM. A pergunta que começou como “qual modelo é mais rápido?” já está mudando para algo mais útil: qual é o melhor modelo que ainda responde mais rápido do que eu consigo ler?
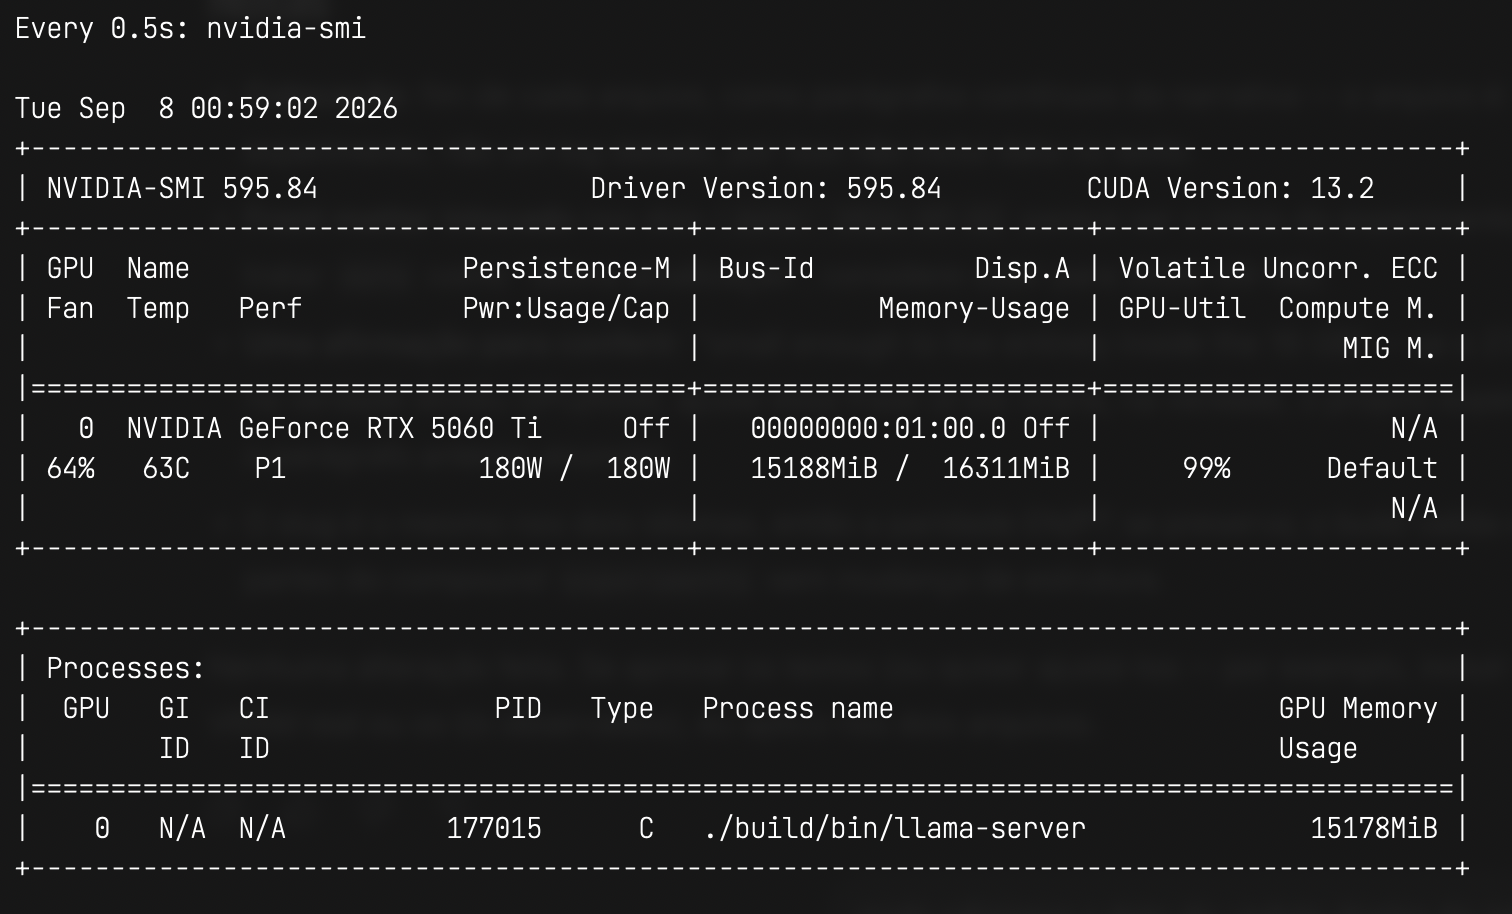
2026-09-06 — antes do experimento de VRAM, o primeiro teste real do harness aconteceu. Rodei o llama-server na ai-01 com o GGUF Qwen3.8-27B-IQ3_XXS do bartowski — um modelo de 27B que vive 100% na VRAM, em 15188 MiB dos 16311 MiB disponíveis — e apontei o DSH, rodando no MacBook, para a VM. Pela primeira vez o harness e o modelo estiveram em máquinas diferentes: o laptop fica sendo a interface, a workstation faz o trabalho.
Um ponto de atrito: o DSH espera uma chave de API, e o llama-server não emite nenhuma. A solução foi trivial — o campo aceita qualquer valor, então ele agora diz local, um placeholder honesto sobre o que é.
Os resultados estão satisfatórios para uso interativo. Antes do experimento de 20B a 32B, duas coisas para registrar: se a quantização IQ3_XXS se sustenta em sessões longas de agente, e quanto de latência o salto do MacBook para a VM realmente custa.
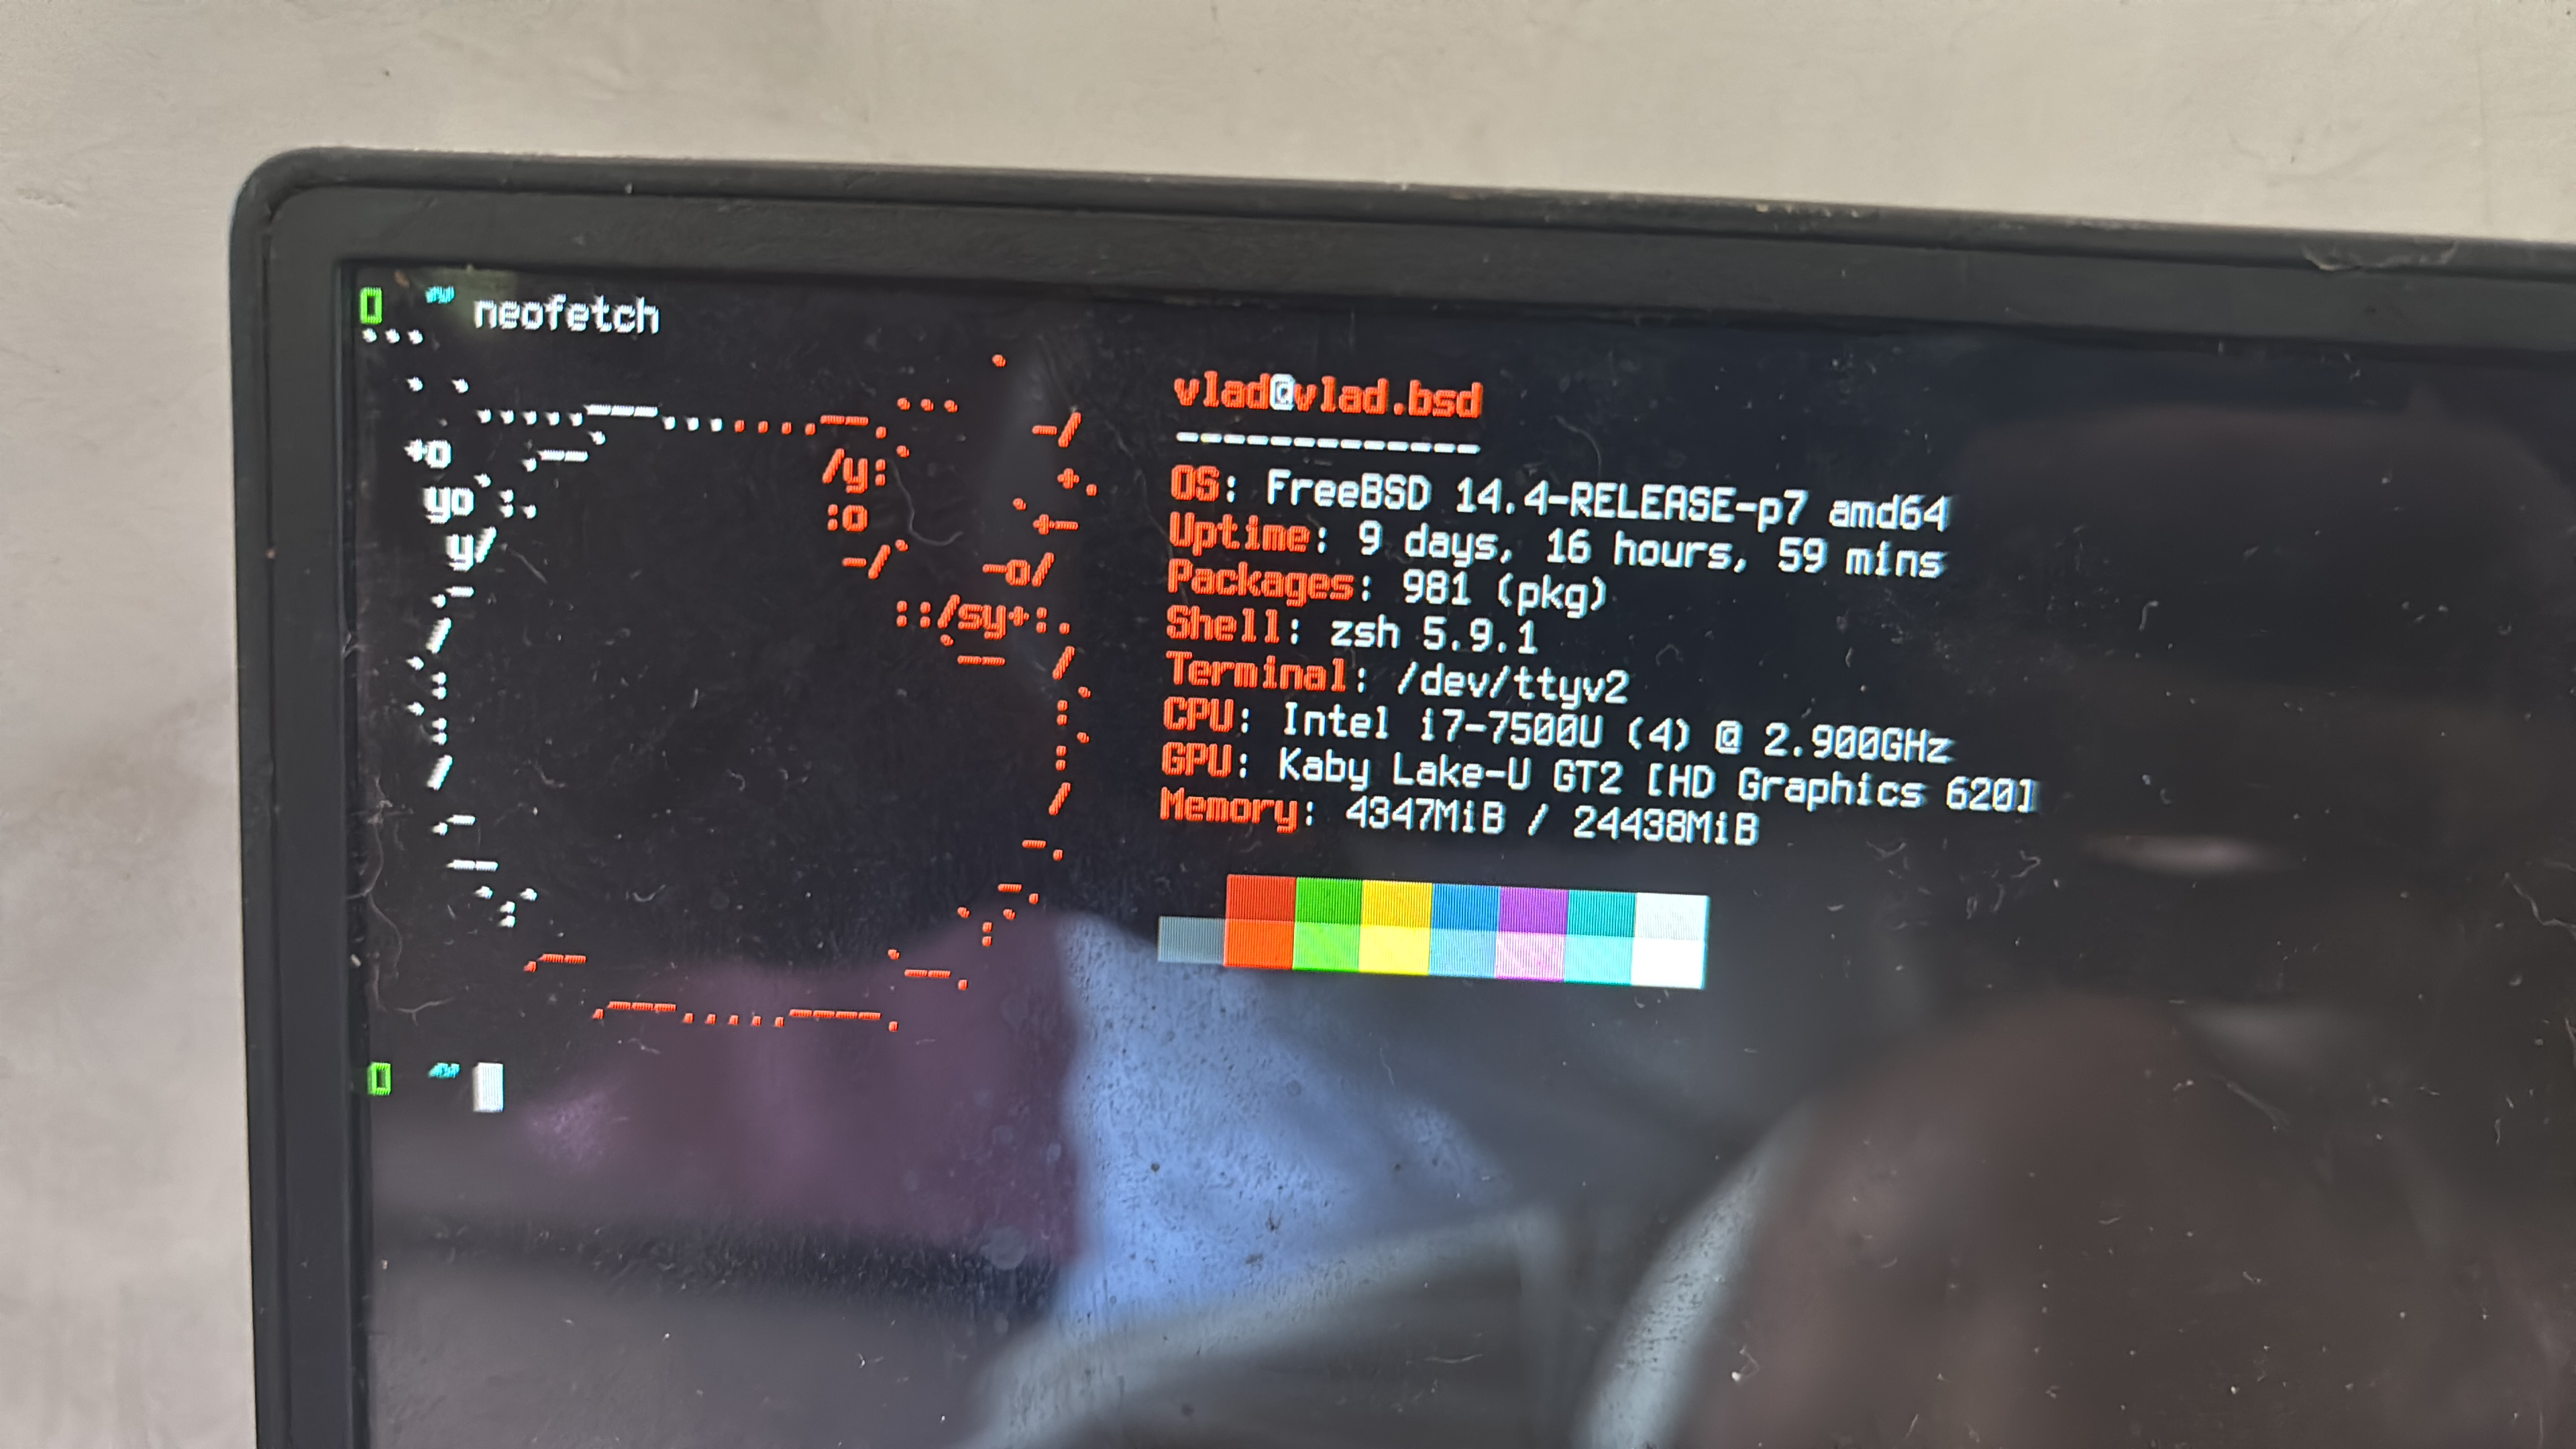
Provisório — as anotações sobre a máquina FreeBSD virão aqui.
Provisório — as anotações sobre a bancada ESP32 virão aqui.
A máquina principal do laboratório. Deu boot e está rodando Proxmox como
hypervisor. Pensada para desenvolvimento de software, modelos locais,
experimentos com agentes, máquinas virtuais e computação de propósito geral.